Diagnostic avant configuration 24 Go
24 Go de VRAM n'est utile que si votre usage actuel bute vraiment sur la mémoire.
OutilsIA Local Cockpit scanne votre PC Windows ou Linux, distingue Ollama Windows/WSL/Linux, inventorie les modèles installés et mesure un modèle local. Le rapport peut recommander 24 Go, un upgrade moins coûteux ou aucun achat.
Notre preuve datée actuelle concerne Hermes 3 8B sur RTX 4080 SUPER 16 Go. Elle démontre le fonctionnement du parcours de mesure, pas les performances d'une RTX 3090 ou 4090.
Les composants proposés plus bas sont des pistes à vérifier. Le diagnostic et le benchmark restent indépendants de ces références.
Verdict en 20 secondes
Si je devais monter un PC pour les LLM locaux aujourd'hui, je partirais sur RTX 3090 24 Go d'occasion propre ou RTX 4090 24 Go neuve, 64 Go DDR5-6000 CL30 EXPO, SSD NVMe 2 To, Ryzen 7 sobre, alim 850W Gold et un Lian Li LANCOOL 216.
La raison est simple : pour les modèles locaux, la VRAM compte plus que le RGB, plus que le CPU extrême, et souvent plus que la génération exacte de la carte. Le PC doit charger le modèle, garder du contexte, rester stable et ne pas transformer chaque prompt en test de patience.
La promesse de cette config
Le but n'est pas de monter un PC gaming avec deux liens IA collés dessus. Le but est de choisir les pièces qui changent vraiment l'expérience LLM locale : assez de VRAM pour charger les bons modèles, assez de RAM pour l'offload et le RAG, un SSD qui ne sature pas au bout de trois tests, et une alimentation qui tient une carte haut de gamme sans stress.
La question à laquelle cette page répond est simple : quoi acheter si je veux faire tourner des modèles locaux sérieusement en 2026 ?
La config recommandée
| Pièce | Choix recommandé | Pourquoi pour les LLM |
|---|---|---|
| CPU | Ryzen 7 7700 / 9700X | Assez de cœurs pour l'OS, l'offload, les outils dev et le RAG sans surpayer. |
| RAM | G.Skill Flare X5 / Trident Z5 Neo 64 Go DDR5-6000 CL30 EXPO, 128 Go si budget | Kit plus cohérent pour AM5 : gros contexte, offload CPU, embeddings, navigateur, IDE, Docker. |
| SSD | NVMe 2 To Gen4 | Les modèles, caches, datasets et environnements Python prennent vite de la place. |
| Alim | 850W Gold minimum | RTX 3090/4090 demandent une alimentation stable, pas juste "assez de watts". |
| Boîtier | Lian Li LANCOOL 216, LANCOOL 207 si format plus compact | Airflow solide, ventilateurs inclus, place pour grosses cartes, prix plus raisonnable que les boîtiers vitrine. |
Modèles locaux valides sur cette config
Pour rendre l'article plus utile que les guides génériques, voici la liste des modèles que je considérerais comme "valides" pour ce type de PC. Valide ne veut pas dire "toujours parfait à 200 tok/s" : ça veut dire chargeable, exploitable, et cohérent avec une machine 24 Go VRAM + 64 Go RAM.
| Modèle | Format conseillé | RTX 3090 24 Go | Usage idéal |
|---|---|---|---|
| Hermes 3 / Nous Hermes | 3B, 8B ou 70B quantifié | 8B très fluide ; 70B (~40 Go en Q4) seulement avec déchargement en RAM | assistant local, roleplay propre, agent perso, réponses moins froides |
| Qwen2.5 Coder / Qwen3 Coder | Qwen2.5 Coder 7B, 14B, 32B Q4 ; Qwen3 Coder 30B-A3B Q4 | 32B Q4 (~20 Go) et 30B-A3B Q4 (~19 Go) tiennent en VRAM | code, scripts, refactor, raisonnement technique |
| DeepSeek Coder / R1 distill | 7B, 14B, 32B Q4 | bon palier en 32B | debug, explication code, tâches agentiques |
| Llama 3.1 / 3.3 | 8B, 70B quantifié | 8B très fluide ; 70B avec déchargement en RAM (lent) | assistant généraliste, rédaction, résumé long |
| Mistral Small / Nemo / Mixtral | Nemo 12B, Small 24B Q4, Mixtral 8x7B quantifié | Nemo et Small tiennent en VRAM ; Mixtral 8x7B Q4 (~28 Go) déborde en RAM | français, RAG, documents, usage quotidien |
| Phi / Gemma | mini et 7B-12B | instantané | petites tâches rapides, extraction, classification locale |
| Codestral | 22B quantifié | bon si quantification adaptée | complétion code, analyse repo, scripts |
| OpenHermes / Dolphin | 7B-13B | très fluide | expérimentation, assistants moins censurés, agents locaux |
Pourquoi parler de Hermes ?
Hermes est exactement le genre de modèle qui rend un PC LLM local interessant. Pas seulement parce qu'il tourne en local, mais parce qu'il donne une sensation d'assistant personnel : plus souple, plus conversationnel, plus facile à brancher sur un RAG privé ou une mémoire locale.
Pour un usage OutilsIA, je le mettrais dans la catégorie "assistant local de travail" : notes, documents, idées, code léger, reformulation, analyse de contexte. Sur une config 24 Go VRAM, tu peux tester les variantes légères très vite et garder les plus gros modèles pour les tâches où la qualité compte plus que la vitesse.
Paliers matériels par niveau de modèle
Ces paliers décrivent une compatibilité mémoire probable, pas une vitesse garantie. Mesurez d'abord votre machine actuelle et n'achetez que si le modèle utile reste bloqué.
| Objectif | Matériel à comparer | À éviter |
|---|---|---|
| Hermes / Qwen 8B | 12 Go VRAM ou mieux | Confondre compatibilité et confort mesuré |
| Qwen / DeepSeek / Mistral 14B | 16 Go VRAM pour davantage de marge | Une carte 8 Go si ce palier est l'usage principal |
| 32B Q4 | 24 Go VRAM à valider au benchmark | Promettre une vitesse à partir de la VRAM seule |
| 70B quantifié / gros RAG | Mémoire unifiée large ou architecture multi-GPU maîtrisée | Un boîtier, une alimentation ou un runtime non adaptés |
| Machine silencieuse | Apple Silicon ou mini-PC à mémoire unifiée, selon les outils | Ignorer les différences CUDA, ROCm et Metal |
Carte visuelle des performances attendues
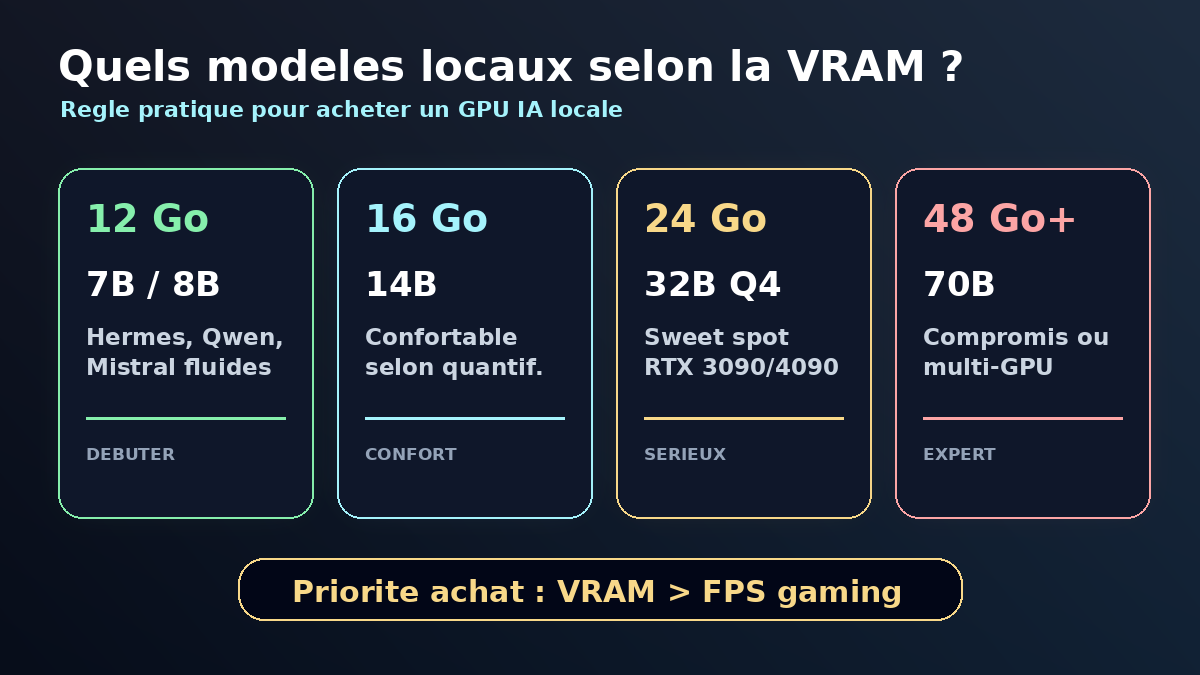
Hermes, Llama, Gemma, Phi pour assistant rapide.
Bon compromis qualité/vitesse sur 16-24 Go VRAM.
Qwen, DeepSeek, Mistral : la raison d'acheter 24 Go.
Possible, mais quantification/offload et patience nécessaires.
Ce que cette machine fait vraiment tourner
Les chiffres ci-dessous sont des ordres de grandeur prudents pour une machine locale bien configurée sous Ollama, LM Studio ou llama.cpp. Les vitesses exactes changent selon le modèle, la quantification, le contexte, le backend, les drivers et le refroidissement.
| Famille de modèle | RTX 3090 24 Go | RTX 4090 24 Go | Confort réel |
|---|---|---|---|
| 7B / 8B Q5-Q8 | très fluide | très fluide | chat, code léger, assistant perso |
| 14B Q4-Q6 | fluide | très fluide | rédaction, analyse, dev quotidien |
| 27B / 32B Q4 | bon palier | excellent | coding, raisonnement, RAG plus sérieux |
| 70B quantifié | possible avec compromis | possible avec compromis | qualité supérieure, vitesse plus lente |
| Image / Flux / SDXL | bon | excellent | génération locale + LLM sur la même tour |
La règle simple : VRAM d'abord
Un PC avec une carte récente mais seulement 8 Go de VRAM peut être un excellent PC gaming et un PC LLM frustrant. Un PC avec 24 Go de VRAM, même sur une carte plus ancienne, donne plus de marge pour charger des modèles utiles.
La hiérarchie pratique pour l'IA locale ressemble à ça : 8 Go = débuter, 12 Go = utile, 16 Go = confortable, 24 Go = sérieux, 48 Go+ = gros modèles.
RTX 3090 ou RTX 4090 ?
La RTX 4090 est meilleure : plus rapide, plus efficace, plus récente. Mais pour beaucoup de builders LLM, la RTX 3090 reste une anomalie intéressante : elle garde 24 Go de VRAM à un prix qui peut être beaucoup plus bas en occasion.
Mon verdict : si tu veux le meilleur rapport capacité/prix, vise une 3090 propre. Si tu veux une machine principale silencieuse, rapide, stable, et que le budget suit, prends une 4090.
Ce que j'éviterais
- RTX 4060 8 Go pour une machine LLM principale : trop vite limitée.
- 32 Go RAM seulement sur un build de ce niveau : c'est dommage, 64 Go est plus cohérent.
- SSD 1 To si tu comptes tester beaucoup de modèles : ça se remplit vite.
- Alim no-name avec RTX 3090/4090 : mauvais endroit pour économiser.
- Boîtier vitrine fermée : beau, mais souvent mauvais pour une carte chaude.
Décision avant achat
Le socle à vérifier est : GPU 24 Go si vos modèles l'exigent, 64 Go de RAM compatible, SSD 2 To, alimentation dimensionnée et boîtier adapté. Le CPU vient après pour une charge principalement GPU.
Vérifiez VRAM, dimensions, garantie, QVL et alimentation avant achat.
Sources et limites
Les recommandations ci-dessus restent des choix d'achat pratiques, pas des promesses de benchmark universelles. Les performances varient selon le modèle, la quantification, le contexte, les drivers, le refroidissement et le backend utilisé.
- NVIDIA explique l'usage des LLM locaux sur PC RTX avec Ollama, AnythingLLM et LM Studio : guide RTX AI Garage.
- SitePoint rappelle que la VRAM utilisable est inférieure à la VRAM affichée et donne des plages de débit pour 10 Go utiles : guide 10GB VRAM local LLM.
- SitePoint résume aussi le workflow local moderne : vérifier RAM/VRAM, installer Ollama ou LM Studio, puis choisir le modèle adapté : guide local LLM 2026.
- Cline donne un bon reality check sur les très gros modèles et les compromis nécessaires en local : Local LLM reality check.
FAQ rapide
Est-ce que cette config remplace ChatGPT ou Claude ?
Non, pas totalement. Elle donne un assistant privé, local, sans abonnement par token, excellent pour documents, code, tests et workflows. Les meilleurs modèles cloud gardent souvent l'avantage sur certains raisonnements lourds.
Faut-il deux GPU ?
Pas pour commencer. Deux GPU compliquent l'alim, le boîtier, la chaleur et le logiciel. Une seule bonne carte 24 Go est le meilleur point de départ.
Un Mac mini est-il une alternative ?
Oui si tu veux silence, faible consommation et mémoire unifiée (jusqu'à 64 Go sur le Mac mini M5 Pro, gamme d'août 2026). Mais pour CUDA, Stable Diffusion, certains outils dev et le meilleur rapport perf brute, le PC NVIDIA garde un gros avantage.