Application native écrite en Rust · Windows et Linux · gratuite

Préparez votre PC à l’IA locale, puis voyez ce qu’il tient vraiment.

Local Cockpit examine le processeur, les barrettes de RAM, la carte graphique, la carte mère et Ollama, puis classe les modèles selon votre machine. Il installe celui que vous choisissez, mesure sa vitesse et compare plusieurs modèles selon vos usages. Vous dialoguez en local, améliorez vos prompts et simulez un upgrade avant tout achat.

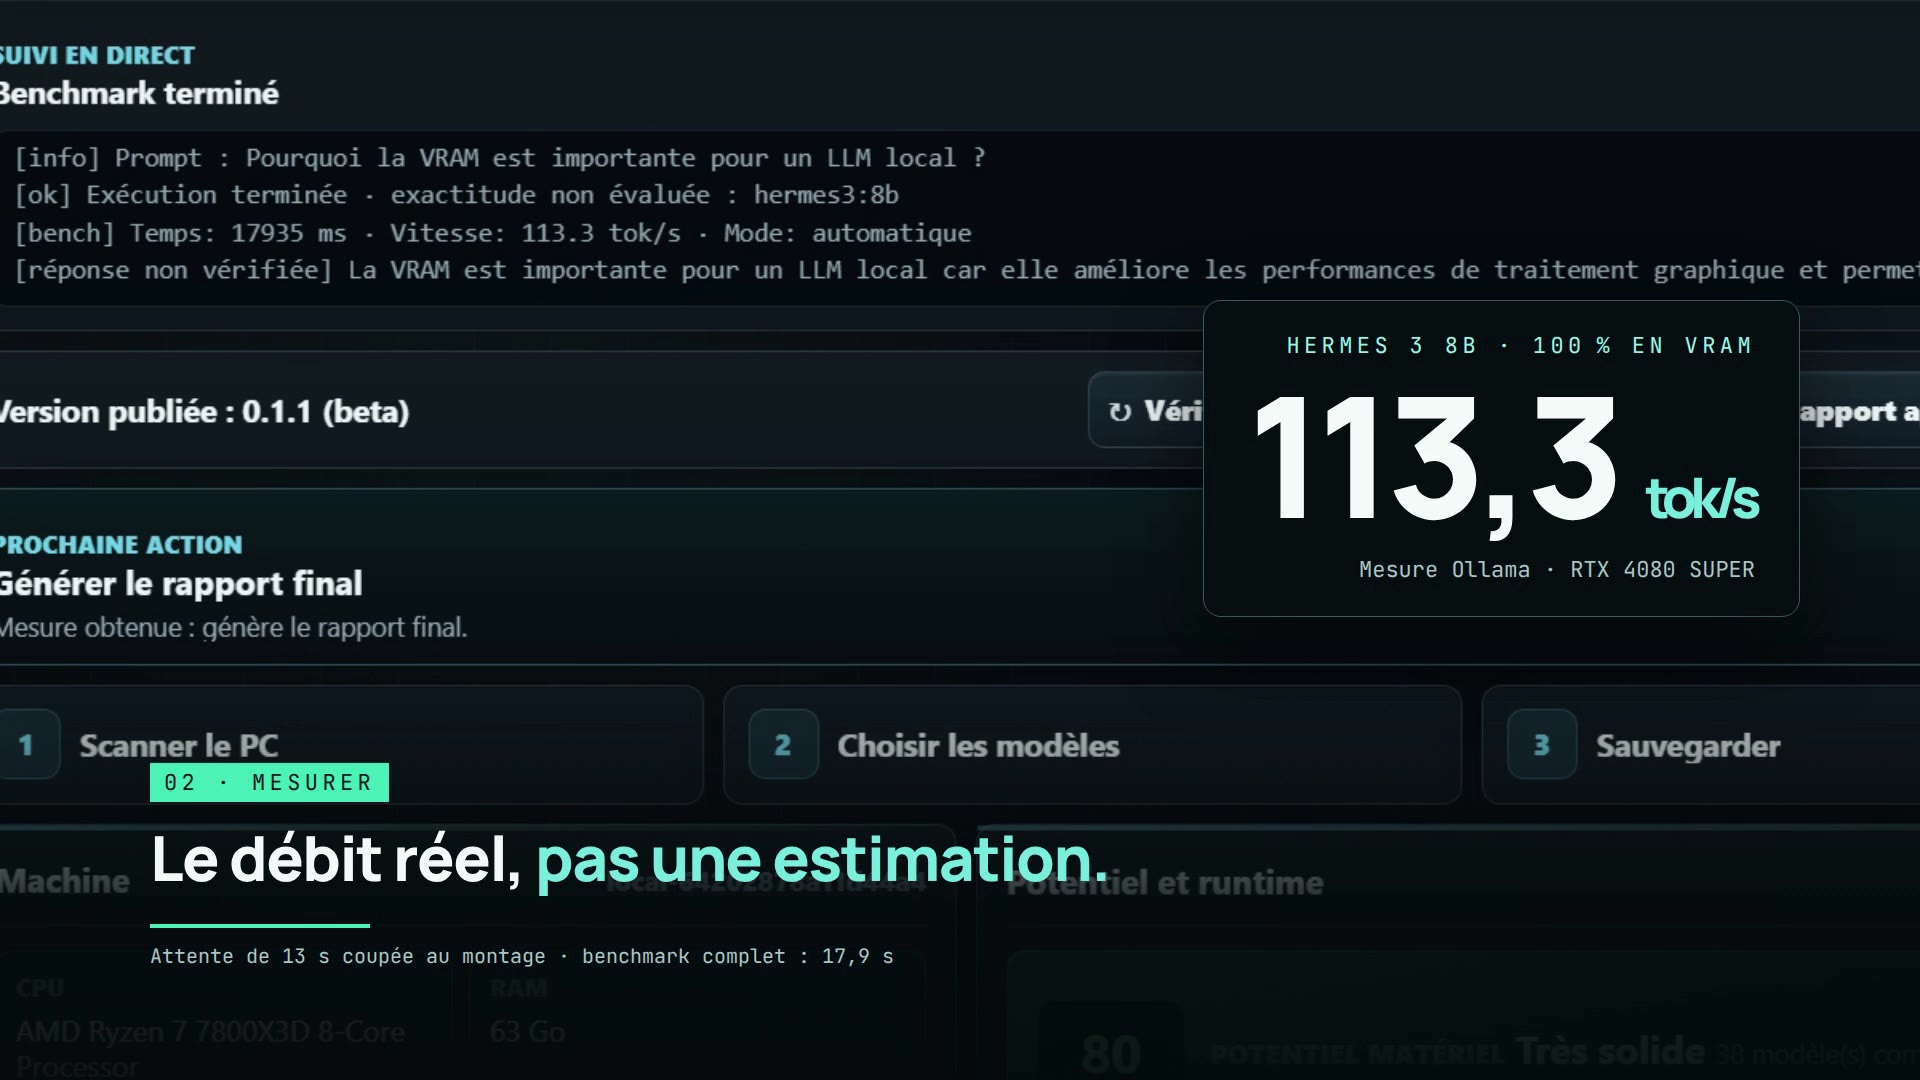
Local Cockpit 0.1.1 : benchmark terminé, Hermes 3 8B à 113,3 tokens par seconde sur RTX 4080 SUPER
Local Cockpit 0.1.1 sur un vrai PC, image de la démonstration filmée. Mesure du 17 octobre 2026 sur cette machine.
Cinq grands usages

De la première analyse à la trace de ce que votre PC sait faire.

Chaque liste décrit la version 0.1.1 que donne le bouton Télécharger. En vert : ce que l’archive 0.1.2, téléchargeable à part, y ajoute.

1. Préparer la machine

Un diagnostic d’atelier, puis le bon modèle installé.

  • Hardware Doctor : score, contrôles VRAM, RAM, canal mémoire, PCIe, température et alimentation, actions conseillées.
  • Barrettes, carte mère, BIOS, slots libres et plafond de RAM : savoir si une barrette tient ou s’il faut changer le kit.
  • Pilote, CUDA, ROCm, charge, puissance et limite, largeur et génération PCIe.
  • Ollama détecté sous Windows, Linux, WSL ou Docker ; Ollama, et WSL sous Windows, installés depuis l’application.
  • Catalogue vivant, indépendant des versions : 60 modèles au 27 octobre 2026. Modèles compatibles, bloqués, nouveaux, à qualifier.
  • 6 profils d’usage (polyvalent, dialogue, code, mémoire, français, portable), avec contexte et quantification conseillés. Préréglage vieux PC portable.
  • Installation avec progression, annulation et console visible. Suppression d’un modèle, erreurs traduites, retest sans GPU pour isoler une panne de pilote.

Archive 0.1.2 : placement réel CPU/GPU en direct, Resizable BAR et Vulkan, contrôle avant téléchargement, recommandation mesurée entre 2 candidats, jumeau d’upgrade.

2. Éprouver les modèles

Le débit réel sur votre PC, et la comparaison selon vos usages.

  • Benchmark Ollama en 6 tests types : question, résumé, code, français, raisonnement, mémoire.
  • Débit en tokens par seconde, historique des résultats, score le plus haut par modèle.
  • Arena : 2 ou 3 modèles installés, classés sur 10 profils (vitesse, assistant, code, mémoire, raisonnement, français, contexte long, portable léger, qualité, compromis). Le score reste indicatif : il ne juge pas l’exactitude des réponses.
  • Impact d’un upgrade : ce qu’il rend accessible, cible à simuler, plan d’action, pack décision et liste d’achats. « Ne rien acheter » reste une conclusion possible.

Archive 0.1.2 : chargement, préremplissage et part sur la carte ; protocole figé, goulot expliqué ; Model Autopilot sur 3 réglages ; Flight Recorder et enquête de régression ; tests privés sur 5 packs.

3. Faire travailler vos modèles

Une fois le modèle installé, Local Cockpit 0.1.1 sert au quotidien :

  • Dialogue local avec préréglages selon l’usage et historique.
  • PromptForge intégré : note un prompt selon des règles, relève ses manques et le réécrit pour le modèle visé.
  • Bibliothèque de prompts.
  • Modes Essentiel et Détails, une seule action suivante à la fois, suivi en direct annulable.

Archive 0.1.2 : génération d’images avec ComfyUI (évaluation, bibliothèque, benchmark 512 × 512) ; ForgeBench, un défi de code à tests cachés scellés ; préparation du travail d’équipe entre agents, avec Codex CLI en pilote.

4. Ouvrir aux assistants

Donnez à vos outils ce que le PC sait de lui-même, sans fouiller vos fichiers.

  • Coffre Obsidian exporté : index, manifeste, machine, modèles, benchmarks, dialogues, fiches, journal.
  • Journal MemoryForge en Markdown et consignes HERMES.md pour un agent.
  • Rapport partagé en lien /r/…, lisible par le serveur MCP public d’OutilsIA depuis un client MCP. Ce serveur, côté site, ne scanne pas votre PC.
  • Pont Strategy Arena : profil JSON borné, sans backtest ni ordre.

Archive 0.1.2 : serveur MCP sur votre PC, en lecture seule : 8 outils et 4 ressources, écoute locale, jeton, 15 minutes par défaut, activé après votre accord. Diagnostic d’Hermes Agent.

5. Prouver ce que votre PC sait faire

Des traces datées, à garder ou à partager quand vous le décidez.

  • Rapport machine prêt, à copier ; rapport PDF modèle et upgrade, par impression.
  • Lien de partage anonymisé, seulement si vous le créez, avec le compte facultatif.
  • Historique local d’instantanés et écart depuis le dernier passage.
  • Fiche de test terrain et checklist, auto-test de l’application et journal d’exécution.

Archive 0.1.2 : carte de preuve sans donnée identifiante, avec audit de confidentialité automatique ; Evidence Ledger, une chaîne d’empreintes sur les plans, exécutions et revues ; révocation des liens partagés.
Démonstration filmée · 44 s · sans son

Local Cockpit en action, sur un vrai PC

  1. Scanner. Un clic sur « Analyser ce PC » : Ryzen 7 7800X3D, 63 Go de RAM, RTX 4080 SUPER 16 Go, Windows 11, Ollama sous WSL.
  2. Choisir. Le modèle conseillé pour cette machine est Hermes 3 8B.
  3. Mesurer. Le benchmark envoie un prompt court à Ollama et lit le débit : 113,3 tok/s. L’attente de 13 s est coupée au montage (test complet : 17,9 s).
  4. Pourquoi mesurer. Le même jour, la même carte et le même modèle ont donné 4,5 tok/s quand d’autres applications occupaient déjà la VRAM.

Captures natives de l’application, sans interface recréée. Mesures du 17/10/2026, sur cette machine. La réponse du modèle n’est pas évaluée par ce test.

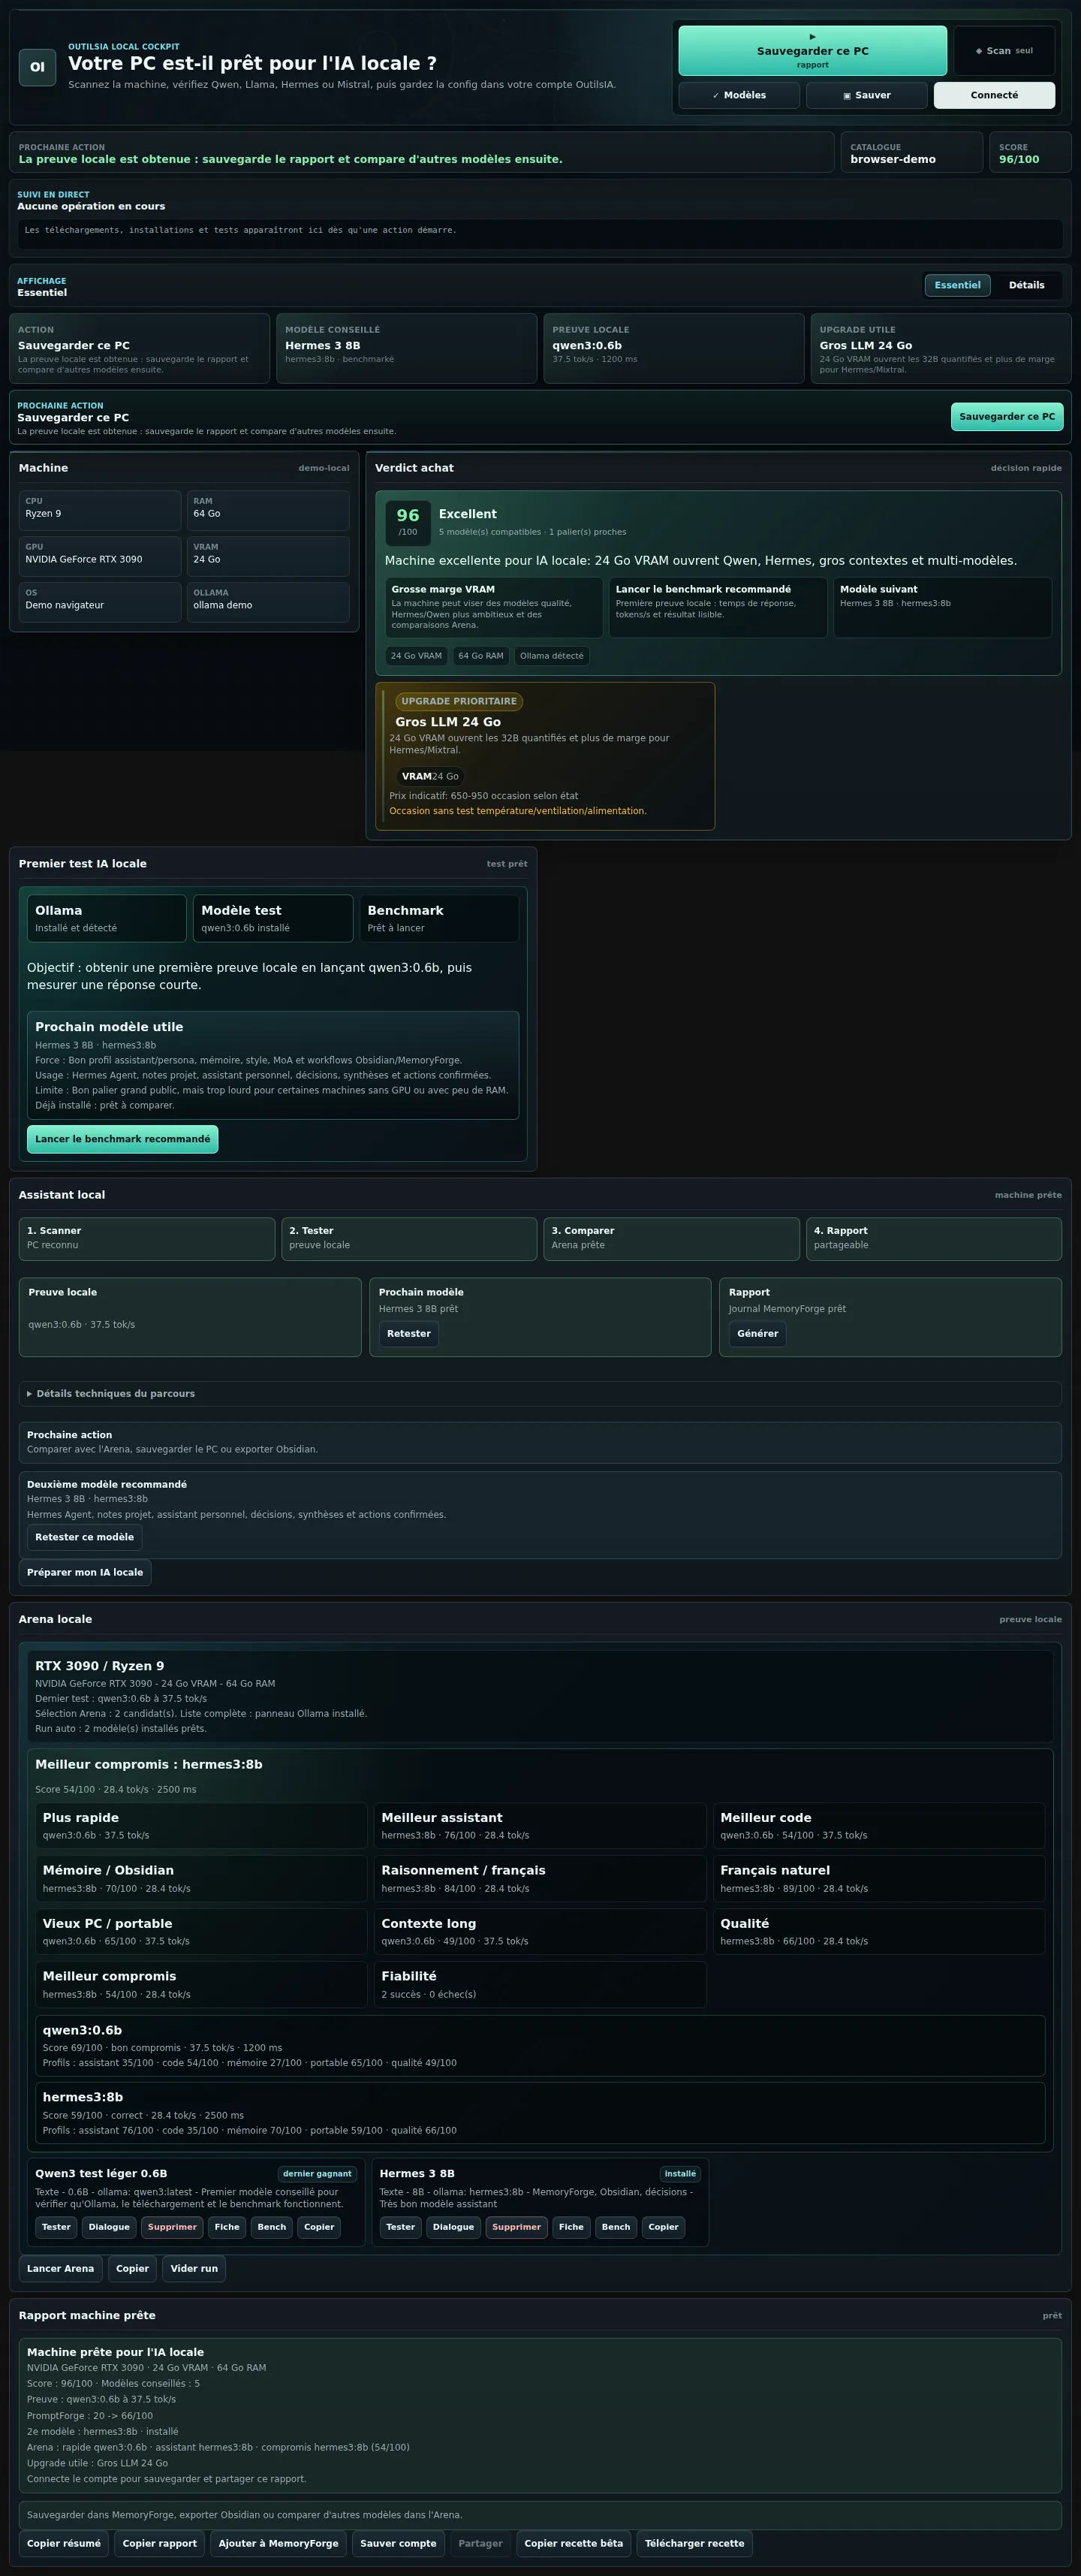
Panneau Arena de Local Cockpit en mode démonstration, chiffres fictifs : classement de deux modèles par profil
Le panneau Arena en mode démonstration, chiffres fictifs. Ce n’est pas une mesure.

L’Arena, pour classer ce que vous avez installé

Un modèle peut gagner en vitesse et un autre en français ou en mémoire. L’Arena les fait passer sur les mêmes tâches et les range profil par profil. Le score indicatif combine la vitesse, la latence, des signaux de sortie, la famille et la taille du modèle.

Voir des exemples de rapports
Réponse en 30 secondes

Quels modèles IA locaux tester selon votre machine ?

Le bon ordre : analyser la machine, lancer un modèle léger de test, comparer un modèle utile, puis décider si un upgrade vaut le coût.

CPU seul / vieux portable

Test : qwen3:0.6b ou petit 3B/4B. But : valider Ollama, mesurer la latence et commencer tout de suite.

8-12 Go VRAM

Cible : Qwen 8B, Llama 3.1 8B, Mistral 7B. Hermes 8B possible selon le runtime, à valider au benchmark.

16 Go VRAM

Cible : Hermes 8B confortable, Qwen 14B, Mistral Nemo 12B, DeepSeek distill 14B. À comparer dans l’Arena.

24 Go VRAM et plus

Certains 27B/32B quantifiés deviennent envisageables au contexte testé. Les poids de Nous Hermes 2 Mixtral font environ 26 Go : 24 Go ne garantissent pas son chargement intégral sur la carte.

Archive 0.1.2 · build du 13 septembre 2026

Pour aller plus loin dès aujourd’hui : l’archive 0.1.2.

Une version plus fournie, téléchargeable à part et non proposée par défaut. Elle a été contrôlée sur un PC physique ; la version recommandée reste la 0.1.1.

  • Régler et surveiller. Model Autopilot teste 3 réglages d’un modèle installé et les applique ou les restaure. Flight Recorder garde des mesures de référence et compare à conditions identiques. La régression confirmée déclenche une enquête sur ses causes.
  • Tester la qualité. 5 packs privés (code, français, résumé, mémoire, métier) à contrôles déterministes, sans envoi au cloud, sans conservation du prompt ni de la sortie.
  • Créer des images. Évaluation de la machine, relais vers l’installeur officiel de ComfyUI, SD 1.5 et SDXL avec source, licence et SHA-256 épinglés, workflows exportables, benchmark standard.
  • Mettre des agents à l’épreuve. ForgeBench : un défi à construire, tests cachés scellés, espaces jetables, évaluation dans un vrai Chromium, échecs conservés comme des résultats.
  • Router le travail. Une carte Planka lue en lecture seule devient un plan à empreinte ; le Capability Router détecte Codex, Claude Code, Hermes, Kimi et les modèles locaux et attribue les rôles.
  • Décider d’un achat. Upgrade Digital Twin : RAM, GPU, stockage, alimentation et flux d’air, chaque contrôle noté confirmé, probable, inconnu ou bloqué.
Fenêtre native de Local Cockpit avec les espaces Accueil, Machine, Modèles, Tests, Assistant, Atelier IA et Compte, pendant un benchmark
Interface par espaces de la lignée 0.1.2. Capture brute d’une candidate 0.1.2-rc.2 du 27 juillet 2026, antérieure à l’archive. Détails de cette mesure.

Dans cette archive, le rapport PDF, l’historique illimité (10 mesures sans licence), la comparaison entre machines, les actions préparées par une IA, la boussole mensuelle et le dossier signé sont réservés à l’Édition Fondateur, pas encore en vente. L’installation de modèles sans programme Ollama sur Windows appartient à la 0.1.1.

Téléchargez Local Cockpit

Application native écrite en Rust, gratuite. Version 0.1.1-beta du 28 septembre 2026 pour Windows x64 et Linux, chaque fichier vérifiable par son SHA-256.

Confiance avant installation

Local Cockpit lit le matériel, pas votre vie privée.

Pour afficher les modèles compatibles, l’application envoie le profil matériel à outilsia.fr, qui fait le calcul : aucun fichier personnel n’est envoyé et aucun compte n’est nécessaire. La synchronisation du compte reste volontaire, le dialogue et les tests tournent sur votre PC.

Lu

CPU, RAM (fabricant, référence et fréquence des barrettes), GPU, VRAM, carte mère, version du BIOS, OS, espace libre du disque système, Ollama, modèles Ollama. Ce profil est envoyé à outilsia.fr pour le calcul de compatibilité.

Jamais lu

Documents, photos, mots de passe, cookies, historique web, emails, clés API.

Appairage propre

Connexion par code court, jeton desktop dédié et révocable, cookie web non copié.

Rapport partageable

Lien anonymisé uniquement si vous choisissez de le créer.

Questions fréquentes

Quel modèle IA local installer sur mon PC ?

Local Cockpit lit le CPU, la RAM, le GPU, la VRAM, le stockage et Ollama, puis classe les modèles du catalogue selon votre machine : modèle conseillé, modèles compatibles et modèles bloqués, avec un petit modèle de test pour commencer.

Une GTX 1080 Ti ou une RTX 3060 suffit-elle pour l’IA locale ?

Oui pour commencer. Local Cockpit propose des modèles légers, puis des 7B, 8B ou 14B quantifiés quand la VRAM et la RAM le permettent.

Que faire avec 8, 12, 16 ou 24 Go de VRAM ?

8 à 12 Go de VRAM permettent d’essayer de petits modèles quantifiés ; 16 Go donnent plus de marge. Certains 27B/32B deviennent envisageables sur 24 Go au contexte testé. La mémoire et la vitesse se mesurent ensuite sur votre machine.

Local Cockpit existe-t-il sous Linux ?

Oui. La version principale propose un installateur et un portable Windows x64, ainsi que des paquets Linux AppImage, .deb et .rpm. Sous Windows, Ollama peut tourner en natif ou dans WSL.

Quelle version le bouton Télécharger donne-t-il ?

La 0.1.1-beta du 28 septembre 2026. L’archive 0.1.2-beta du 13 septembre, plus fournie, reste téléchargeable à part. Le numéro ne suit pas l’ordre des builds : la 0.1.1 est la plus récente et la version recommandée.

Que faut-il pour commencer ?

Un PC Windows x64 ou Linux. Ollama peut être installé depuis l’application. Le calcul de compatibilité a besoin d’une connexion à outilsia.fr ; le compte reste facultatif. Le parcours avec Ollama dans Docker et l’installation complète sous Linux sont encore à qualifier sur le terrain.

Vous avez un PC à mémoire unifiée ? Participez aux tests. Un souci ? Problèmes connus et mesures datées.

Des mesures datées

Mesure du 27 juillet 2026, sur une candidate 0.1.2-rc.2 : Hermes 3 8B à 118,5 tok/s sur une RTX 4080 SUPER 16 Go, avec Ollama sous WSL. C’est une machine, pas une performance universelle. La capture et son empreinte SHA-256 sont publiées.

Voir cette mesure · Toutes les mesures datées

Guides associés à Local Cockpit

Les articles du blog qui vont avec ce logiciel.

Tous les guides Local Cockpit

Fiche technique de Local Cockpit

RôlePréparer un PC à l’IA locale : diagnostic du matériel, installation d’un modèle, benchmark
Version0.1.1-bêta, 28 septembre 2026
SystèmesWindows x64 ; Linux (AppImage, .deb, .rpm)
PrixGratuit
CodeConsultable sur GitHub, sans licence libre
MesuréHermes 3 8B à 113,3 tok/s sur RTX 4080 SUPER 16 Go, le 17 octobre 2026 ; preuves détaillées
Vérifié26 tests Rust sous Linux, 26 sous Windows, 6 cas navigateur, essai natif sous Windows
Pas encore vérifiéCycle complet d’installation sous Windows, installation externe de Docker, parcours interactif d’un modèle sous Linux
GitHubNotes de version et empreintes