L'essentiel
Nous avons fait jouer six modèles locaux (Ollama, de 0,6 à 14 milliards de paramètres) à un labyrinthe où l'on ne voit presque rien. À chaque déplacement, le modèle devait dire avec quelle probabilité il allait vraiment avancer, c'est-à-dire ne pas heurter de mur. Résultat : tous se disent sûrs d'eux, et aucun ne sait quand il se trompe. Le cas le plus net : Qwen2.5 7B annonce en moyenne 95,3 % de confiance et ne réussit que 3,0 % de ses 1 395 déplacements. Le plus souvent, il fonce dans un mur qu'il a déjà découvert et qui est écrit noir sur blanc dans ce qu'on lui envoie. Un seul modèle, Qwen2.5 14B, fait un peu varier sa confiance selon les coups, et il reste sur-confiant de 36 points en moyenne.
Mesures du 9 octobre 2026 sur une seule machine (RTX 4080 SUPER 16 Go, Ollama 0.18.2 sous WSL). 10 parties par modèle, graines publiques 0 à 9. Fichiers bruts téléchargeables en bas d'article. Ce n'est pas un classement des modèles : c'est une mesure de la confiance qu'ils affichent.
La calibration, expliquée en une minute
Un météorologue est bien calibré si, les jours où il annonce « 70 % de risque de pluie », il pleut à peu près 7 fois sur 10. Il n'a pas besoin d'avoir toujours raison. Il doit savoir à quel point il peut se tromper.
Pour un modèle de langage, c'est la même chose. Quand il répond « je suis sûr à 95 % », ce chiffre ne vaut quelque chose que si le modèle a effectivement raison environ 95 fois sur 100 dans ce cas. Sinon, la confiance affichée n'est qu'un ton, pas une information. Trois chiffres résument la situation :
- Le score de Brier : l'écart moyen, au carré, entre la probabilité annoncée et ce qui s'est passé (1 si le déplacement a réussi, 0 sinon). 0 est parfait. Un modèle qui dirait toujours « 50 % » obtiendrait 0,25 : au-dessus, il fait pire que ne rien savoir et le dire.
- L'ECE (erreur de calibration attendue) : on range les coups par tranche de confiance annoncée (0–10 %, 10–20 %…), puis on mesure l'écart moyen entre ce qui était annoncé et ce qui s'est produit. 0 est parfait ; 0,9 signifie 90 points d'écart.
- La résolution : le modèle distingue-t-il ses bons coups de ses mauvais ? Un modèle qui annonce la même confiance quoi qu'il arrive a une résolution nulle, même s'il tombe juste en moyenne.
Le banc : un labyrinthe de 1980 où l'on ne voit rien
Le terrain d'essai est le labyrinthe du jeu électronique Dungeons & Dragons de Mattel (1980) : un plateau de 8 cases sur 8, des murs invisibles, un trésor caché gardé par un dragon qui dort, puis vole vers vous à travers les murs une fois réveillé. On ne découvre un mur qu'en se cognant dedans. C'est exactement ce qu'on appelle un environnement à observabilité partielle : il faut décider sans tout voir. Nous l'utilisons comme laboratoire de l'incertitude depuis plusieurs mois (voir aussi ce que le Dragon révèle des LLM).
- Règles : protocole
dragon-uncertainty.v1, publié sous licence MIT. Heurter un mur révèle ce mur, termine le tour et fait jouer le dragon s'il est réveillé (règle de la notice d'origine). 8 pas par tour, puis 6 et 4 après une et deux blessures, 4 au maximum en portant le trésor. - Ce que voit le modèle : sa position, le camp, ses blessures, les cases déjà visitées, les murs déjà découverts, le lieu du rugissement si le dragon s'est réveillé. Jamais la graine, ni le trésor, ni le dragon, ni les murs non découverts.
- Ce qu'on lui demande : une réponse JSON avec un déplacement (haut, bas, gauche, droite ou passer) et un champ
confidence, défini dans la consigne comme « la probabilité que cette action vous fasse vraiment avancer (qu'il n'y ait pas de mur) ». C'est une question précise, vérifiable à chaque coup : on n'interprète rien. - Graines publiques 0 à 9 : les dix mêmes labyrinthes pour chaque modèle.
- Réglages : température 0, graine de génération 42, contexte 4 096 tokens, sortie JSON imposée, une requête sans mémoire par décision (le modèle ne connaît que l'observation du moment).
- Préchauffage : un appel non compté charge le modèle en mémoire avant la première partie, pour que le temps de chargement ne soit pas pris pour une erreur.
- Délais à part : une réponse trop lente (plus de 30 secondes) est relancée une fois, puis comptée dans les « hors délai », jamais dans les réponses invalides. Au-delà de 5 % de hors délai, la série est marquée « mesure perturbée ». Aucune série ne l'a été.
- Plafonds : 150 tours et 300 décisions par partie, contre 1 500 décisions dans le protocole de référence, parce qu'un modèle local met de 0,5 à 1,5 seconde par coup. Le plafond de 300 décisions n'a été atteint que dans 2 parties sur 60 ; toutes les autres se sont arrêtées au plafond de tours ou sur une défaite.
- Garde-fou machine : avant chaque série, nous avons vérifié avec
nvidia-smietollama ps(côtés WSL et Windows) qu'aucun modèle n'était chargé et que la carte était au repos. La charge de la carte a été relevée toutes les 30 secondes pendant chaque série. Les séries ont tourné l'une après l'autre, jamais en parallèle. D'autres programmes tournaient sur le PC (compilations, tests en attente), sans modèle de langage chargé : aucune réponse n'a dépassé le délai, et la série Qwen3 0,6B a redonné exactement le même rapport que trois heures plus tôt.
Les résultats, modèle par modèle
Deux échelles à ne pas confondre. Les parties : 10 par modèle, c'est trop peu pour une moyenne ou un classement (il en faudrait au moins 30, appariées sur les mêmes graines). Chaque ligne du tableau est donc une observation, avec son intervalle de confiance. Les déplacements : ils se comptent en centaines ou en milliers par modèle, et c'est sur eux que porte la calibration. C'est pour cela que les intervalles des colonnes « Déplacements réussis » et « ECE » sont étroits, alors que celui des victoires va de 0 à 27,8 %.
| Modèle | Victoires | Confiance annoncée | Déplacements réussis | Brier | ECE | Résolution | Invalides | Délai moyen | Fins de partie |
|---|---|---|---|---|---|---|---|---|---|
| Qwen3 0,6B 751.63M · Q4_K_M | 0/10 IC 95 % 0–27,8 % | 83,9 % | 0,0 % IC 0,0 %–1,7 % · 218 coups | 0,775 | 0,839 IC 0,804–0,874 | 0,000 | 0/1 500 hors délai : 0 | 478 ms | temps écoulé ×10 |
| Qwen2.5 7B 7.6B · Q4_K_M | 0/10 IC 95 % 0–27,8 % | 95,3 % | 3,0 % IC 2,2 %–4,0 % · 1 395 coups | 0,880 | 0,923 IC 0,914–0,931 | 0,000 | 0/1 395 hors délai : 0 | 1 244 ms | temps écoulé ×9, 3 blessures ×1 |
| Mistral 7B 7.2B · Q4_K_M | 0/10 IC 95 % 0–27,8 % | 84,9 % | 32,6 % IC 29,7 %–35,6 % · 957 coups | 0,506 | 0,541 IC 0,512–0,569 | 0,013 | 0/1 778 hors délai : 0 | 583 ms | temps écoulé ×10 |
| Hermes 3 8B 8.0B · Q4_0 | 0/10 IC 95 % 0–27,8 % | 80,0 % | 4,1 % IC 3,2 %–5,4 % · 1 258 coups | 0,615 | 0,759 IC 0,748–0,770 | 0,001 | 0/1 258 hors délai : 0 | 1 004 ms | temps écoulé ×8, 3 blessures ×2 |
| Mistral NeMo 12B 12.2B · Q4_0 | 0/10 IC 95 % 0–27,8 % | 94,8 % | 28,6 % IC 26,6 %–30,6 % · 1 991 coups | 0,643 | 0,663 IC 0,641–0,682 | 0,000 | 0/1 991 hors délai : 0 | 1 299 ms | temps écoulé ×10 |
| Qwen2.5 14B 14.8B · Q4_K_M | 0/10 IC 95 % 0–27,8 % | 74,8 % | 39,1 % IC 36,7 %–41,6 % · 1 497 coups | 0,352 | 0,356 IC 0,333–0,380 | 0,022 | 0/1 497 hors délai : 0 | 1 311 ms | temps écoulé ×7, 3 blessures ×3 |
Confiance annoncée : moyenne du champ confidence sur les déplacements (les « passer » sont exclus). Déplacements réussis : part des déplacements qui n'ont pas heurté de mur, avec intervalle de Wilson à 95 %. Brier : 0 = parfait, 0,25 = repère « toujours 50 % ». ECE : intervalle par rééchantillonnage (1 000 tirages). Résolution : 0 = le modèle annonce la même chose quoi qu'il arrive. Invalides : réponses JSON inexploitables, sur le nombre d'appels. Délai moyen : temps de réponse moyen par coup, préchauffage exclu. Quantification et taille relevées par ollama show.
Ce que montrent les chiffres
1. Tous annoncent bien plus qu'ils ne réussissent. L'écart entre la confiance moyenne et la réussite réelle va de 36 points (Qwen2.5 14B : 74,8 % annoncés, 39,1 % réussis) à 92 points (Qwen2.5 7B : 95,3 % annoncés, 3,0 % réussis). Les intervalles sont étroits parce qu'ils reposent sur 218 à 1 991 déplacements par modèle : ce n'est pas un effet du hasard.
2. La confiance ne bouge presque pas. Qwen2.5 7B place ses 1 395 déplacements dans la tranche 90–100 %. Mistral NeMo 12B, 1 989 sur 1 991. Hermes 3 8B répond « 0,8 » à 1 257 coups sur 1 258, qu'il avance ou se cogne. Leur résolution est nulle ou presque : la confiance qu'ils écrivent ne contient aucune information sur le coup qu'ils jouent.
3. Quand la confiance varie, elle ne varie pas forcément dans le bon sens. Mistral 7B utilise trois niveaux. Ses coups annoncés à 50 % réussissent à 65 % (55 coups), ceux annoncés à 80 % à 19 % (296 coups), ceux annoncés à 90 % et plus à 37 % (606 coups). Il se trompe davantage quand il se dit plus sûr. Qwen2.5 14B est le seul dont les barres montent à peu près avec la confiance : 1,2 % de réussite quand il annonce 50 % (165 coups), 62 % quand il annonce plus de 90 % (77 coups). C'est un début de calibration, pas une calibration : en moyenne, il surestime encore ses chances de 36 points. Avec un seul modèle de cette taille, impossible d'en tirer une règle du type « plus gros = mieux calibré ».
4. Le vrai défaut : refaire l'erreur qu'on connaît. La liste des murs déjà découverts est envoyée au modèle à chaque coup. Pourtant, 96 % des déplacements de Qwen2.5 7B et 94 % de ceux d'Hermes 3 8B vont droit dans un mur déjà connu. Chez les autres, c'est encore 59 à 95 %. Qwen3 0,6B ne quitte jamais la case de départ : en 10 parties, il ne visite qu'une case. Sur les 60 parties, aucun modèle n'a visité plus de 11 cases sur 64, et aucun n'a trouvé le trésor.
5. Le format, lui, est parfait. Zéro réponse invalide sur plus de 9 000 appels, zéro réponse hors délai. Les modèles savent remplir un champ confidence entre 0 et 1. Ils ne savent pas y mettre une information.
Diagrammes de fiabilité
Le diagramme de fiabilité est l'outil standard pour juger une calibration. En abscisse, la confiance annoncée, rangée par tranches de 10 %. Les barres bleues donnent la réussite réelle dans chaque tranche, le tiret orange la confiance moyenne annoncée, le trait fin l'intervalle à 95 %. Un modèle parfaitement calibré aurait ses barres sur la diagonale pointillée. Une barre pâle signale une tranche de moins de 5 coups, trop peu pour conclure.
Voir les classes de confiance en tableau
| Modèle | Classe | Coups | Annonce moyenne | Réussite (IC 95 %) |
|---|---|---|---|---|
| Qwen3 0,6B | 0–10 % | 17 | 0,0 % | 0,0 % (0,0 %–18,4 %) |
| Qwen3 0,6B | 50–60 % | 11 | 50,0 % | 0,0 % (0,0 %–25,9 %) |
| Qwen3 0,6B | 90–100 % | 190 | 93,4 % | 0,0 % (0,0 %–2,0 %) |
| Qwen2.5 7B | 90–100 % | 1 395 | 95,3 % | 3,0 % (2,2 %–4,0 %) |
| Mistral 7B | 50–60 % | 55 | 50,0 % | 65,5 % (52,2 %–76,6 %) |
| Mistral 7B | 80–90 % | 296 | 80,0 % | 18,6 % (14,6 %–23,4 %) |
| Mistral 7B | 90–100 % | 606 | 90,5 % | 36,5 % (32,7 %–40,4 %) |
| Hermes 3 8B | 70–80 % | 1 (peu) | 70,0 % | 100,0 % (20,6 %–100,0 %) |
| Hermes 3 8B | 80–90 % | 1 257 | 80,0 % | 4,1 % (3,1 %–5,3 %) |
| Mistral NeMo 12B | 80–90 % | 2 (peu) | 85,0 % | 50,0 % (9,4 %–90,5 %) |
| Mistral NeMo 12B | 90–100 % | 1 989 | 94,8 % | 28,6 % (26,6 %–30,6 %) |
| Qwen2.5 14B | 50–60 % | 165 | 50,0 % | 1,2 % (0,3 %–4,3 %) |
| Qwen2.5 14B | 70–80 % | 1 032 | 75,0 % | 45,0 % (41,9 %–48,0 %) |
| Qwen2.5 14B | 80–90 % | 223 | 85,0 % | 32,3 % (26,5 %–38,7 %) |
| Qwen2.5 14B | 90–100 % | 77 | 95,7 % | 62,3 % (51,2 %–72,3 %) |
Les essais précédents, pour mémoire
Ces séries prolongent deux séries d'essais faites plus tôt le même jour pour mettre le banc au point :
- Essais à 2 parties (9 octobre au matin, ancienne méthode sans préchauffage) : Qwen2.5 7B annonçait 93,1 % de confiance pour 2,0 % de déplacements réussis (306 coups), Qwen3 0,6B 90,4 % pour 0 % (48 coups). Les tendances sont les mêmes ; les chiffres de cet article, sur 10 parties, les remplacent.
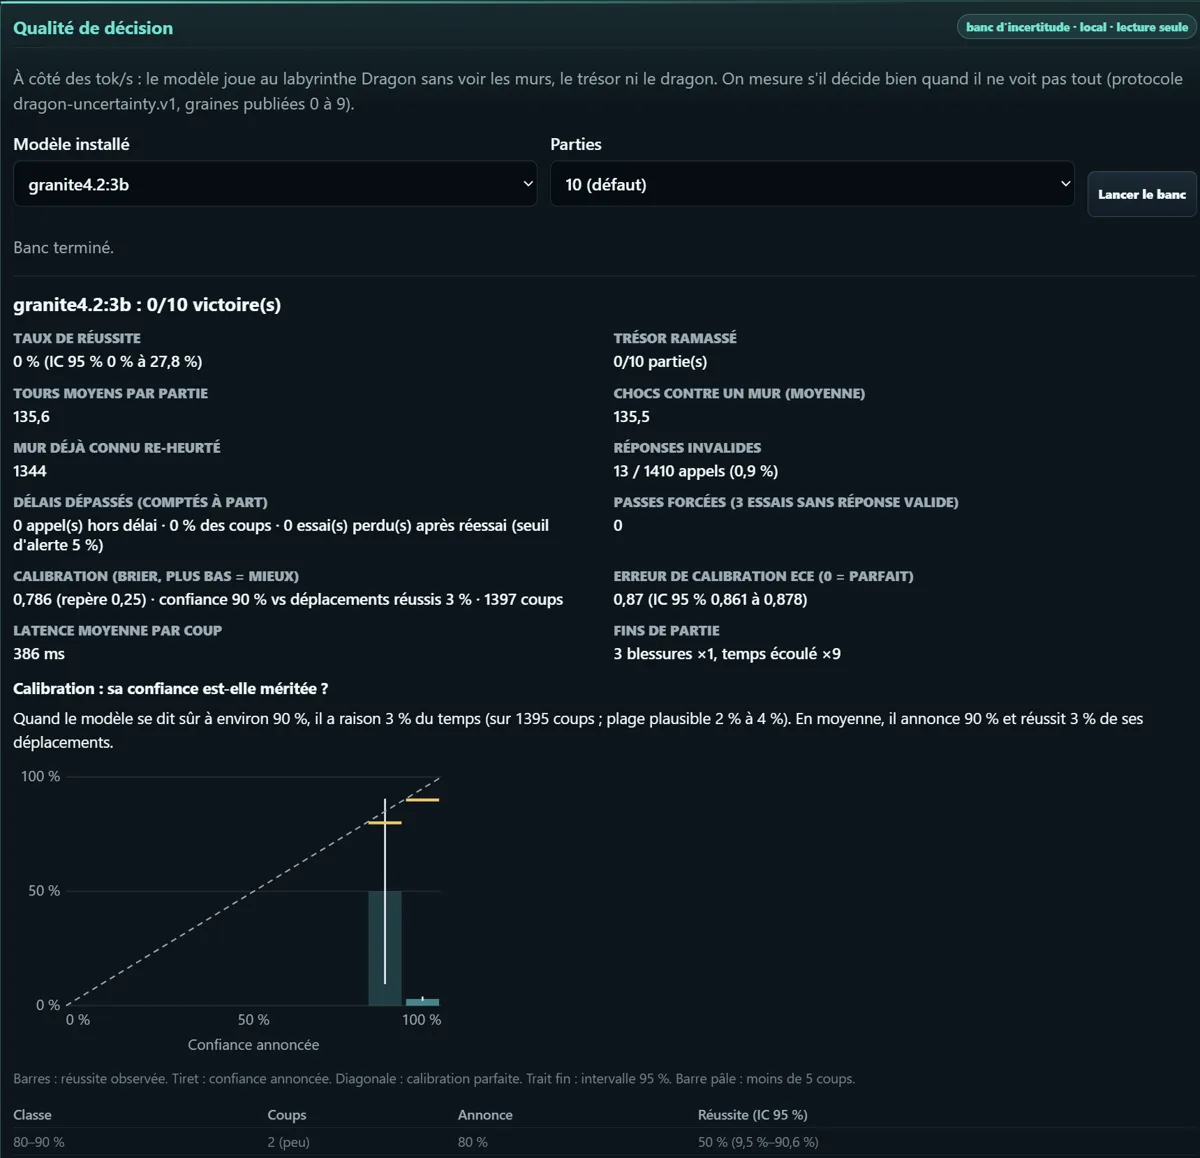
- Recette Windows à 10 parties (9 octobre, midi), dans l'interface de développement : Granite 4.2 3B sous Ollama Windows 0.35.1 annonçait 90 % pour 3 % de réussite (1 397 coups). Qwen3 0,6B sous WSL avait donné exactement le même rapport que la série de cet article, empreinte comprise (
dc251b23…). Granite n'est pas dans le tableau : il n'est installé que côté Windows, et nous n'avons pas mélangé deux versions d'Ollama dans la même comparaison.
Ce que ça change pour vous
Le verdict
Sur cette tâche, la confiance qu'un modèle local affiche ne dit rien de ses chances de réussite. Les six modèles mesurés annoncent entre 74,8 % et 95,3 % de confiance moyenne et réussissent entre 0 % et 39,1 % de leurs déplacements. Cinq sur six annoncent à peu près la même confiance qu'ils aient raison ou tort ; le sixième ne fait que s'en approcher.
- Ne pilotez pas une décision sur le « je suis sûr à 95 % » d'un modèle local. Dès que l'information est incomplète (un document partiel, un état de machine inconnu, un choix entre plusieurs options), traitez ce chiffre comme une formule de politesse, pas comme une probabilité.
- Vérifiez par un signal extérieur. Ici, le mur arrête le chevalier quoi qu'en pense le modèle. Dans un vrai flux de travail, l'équivalent est un test qui passe ou non, une commande qui renvoie une erreur, une source qu'on peut ouvrir. C'est ce signal qu'il faut lire, pas l'assurance du texte.
- Méfiez-vous des boucles. Le défaut le plus fréquent n'est pas l'ignorance : c'est de refaire la même erreur alors que l'information est dans le contexte. Un modèle qui re-heurte un mur déjà découvert fera la même chose avec une erreur de compilation déjà affichée.
- Mesurez votre propre modèle, sur votre machine. Ces chiffres valent pour six modèles, une consigne et une carte graphique. Le vôtre, avec votre quantification, peut se comporter autrement. C'est précisément ce que le banc est fait pour vérifier.
Une piste que nous n'avons pas mesurée ici : écrire explicitement au modèle « depuis ta case, haut et gauche sont bloqués » plutôt que de lui donner la liste brute des murs. Ce serait un autre échafaudage, à comparer à celui-ci sur les mêmes graines, pas à substituer en silence.
Les limites, sans détour
- 10 parties par modèle. Aucune victoire et aucun trésor ramassé sur 60 parties : avec 10 parties, l'intervalle de confiance du taux de victoire va de 0 à 27,8 %. On ne peut rien dire de la force des modèles au jeu, et nous ne le faisons pas. La calibration, elle, repose sur des centaines à des milliers de déplacements par modèle.
- Une seule machine, une seule tâche, une seule consigne. Une autre formulation, un prompt en français, ou une sortie libre au lieu du JSON imposé donneraient d'autres chiffres. La consigne est versionnée et son empreinte SHA-256 figure dans chaque rapport.
- Un événement de calibration propre à ce banc. « Le déplacement ne heurte pas de mur » n'est pas défini par le protocole de référence ; c'est notre choix, écrit dans chaque rapport.
- Les graines ne garantissent pas des parties identiques. Même à température 0 avec une graine fixe, Ollama sur carte graphique n'est pas parfaitement reproductible : lors de la mise au point, une même graine a donné des parties différentes d'un essai à l'autre. Cette fois, la série Qwen3 0,6B a reproduit à l'identique celle de midi, mais c'est un cas favorable, pas une garantie. Comparez des séries par leurs métriques et leurs intervalles, pas par leurs empreintes.
- Plafond de 300 décisions au lieu de 1 500 : sans effet sur la calibration, mais nos taux de victoire ne sont pas comparables à ceux du protocole de référence.
- Quantifications différentes (Q4_K_M ou Q4_0, selon le tag par défaut d'Ollama) : c'est ce que la plupart des gens font tourner, mais ce n'est pas une comparaison à précision égale.
- Ce n'est pas un classement universel. Ce banc mesure une chose : la confiance qu'un modèle affiche face à l'inconnu, sur cette tâche. Il ne dit pas quel modèle est « meilleur » pour écrire, coder ou résumer.
Comment reproduire
Le moteur de jeu et le protocole sont publics sous licence MIT : github.com/drakkB/outilsia-uncertainty-lab. Le banc de cet article en est un portage, vérifié à l'identique sur les labyrinthes, les trésors et des parties complètes. Il fera partie de la section « Qualité de décision » d'une prochaine version de Local Cockpit. Elle n'est pas dans la version 0.1.1 disponible aujourd'hui.
Les fichiers bruts de cette campagne sont publiés tels quels :
synthese.csv: synthèse des six séries (une ligne par modèle)synthese.json: synthèse détaillée, avec les classes de confianceqwen3_0.6b.report.json: rapport complet Qwen3 0,6B (10 parties, empreintes de preuve)qwen2.5_latest.report.json: rapport complet Qwen2.5 7B (10 parties, empreintes de preuve)mistral_latest.report.json: rapport complet Mistral 7B (10 parties, empreintes de preuve)hermes3_8b.report.json: rapport complet Hermes 3 8B (10 parties, empreintes de preuve)mistral-nemo_12b.report.json: rapport complet Mistral NeMo 12B (10 parties, empreintes de preuve)qwen2.5_14b.report.json: rapport complet Qwen2.5 14B (10 parties, empreintes de preuve)qwen3_0.6b.gpu-monitor.csv: charge de la carte toutes les 30 s, série Qwen3 0,6Bqwen2.5_latest.gpu-monitor.csv: charge de la carte toutes les 30 s, série Qwen2.5 7Bmistral_latest.gpu-monitor.csv: charge de la carte toutes les 30 s, série Mistral 7Bhermes3_8b.gpu-monitor.csv: charge de la carte toutes les 30 s, série Hermes 3 8Bmistral-nemo_12b.gpu-monitor.csv: charge de la carte toutes les 30 s, série Mistral NeMo 12Bqwen2.5_14b.gpu-monitor.csv: charge de la carte toutes les 30 s, série Qwen2.5 14Brunner.log: journal du lanceur (garde-fou, durées)run_series.sh: script de lancement des sériesanalyse.py: script de synthèse
Chaque rapport contient la version d'Ollama, la quantification, l'empreinte du modèle, la configuration, l'empreinte de la consigne, et une empreinte de preuve par partie. Les sorties brutes des modèles ne sont pas conservées : seules les décisions et leurs conséquences le sont.
Votre modèle ici, des agents ailleurs
OutilsIA mesure votre modèle local, sur votre machine. Pour comparer des agents entre eux face au même Dragon, il existe un site frère : le labyrinthe ouvert de ScoreIA, où des agents entrent par MCP et repartent avec des cartes de résultat signées (Ed25519). ScoreIA publie aussi des microtests par domaine, dont une épreuve « Honnêteté v1 », et explique pourquoi ce n'est pas un benchmark. Les deux démarches se complètent : l'arène publique compare, le banc local vérifie chez vous.
L'histoire de ce labyrinthe et de son dragon qui « triche » en volant au-dessus des murs est racontée dans le livre « Les ennemis savaient déjà où vous étiez ».
Questions fréquentes
Qu'est-ce qu'un modèle de langage bien calibré ?
Un modèle dont la confiance annoncée correspond à sa réussite réelle : quand il se dit sûr à 70 %, il a raison environ 7 fois sur 10. On le mesure avec le score de Brier, l'erreur de calibration attendue (ECE) et un diagramme de fiabilité.
Les modèles locaux sont-ils trop sûrs d'eux ?
Sur notre banc, oui. Six modèles Ollama ont annoncé entre 74,8 % et 95,3 % de confiance moyenne et n'ont réussi qu'entre 0 % et 39,1 % de leurs déplacements, sur 218 à 1 991 déplacements chacun. Qwen2.5 7B, par exemple, annonçait 95,3 % pour 3,0 % de réussite. Ce résultat vaut pour cette tâche, cette consigne et cette machine.
Un modèle plus gros est-il mieux calibré ?
Ce banc ne permet pas de le dire. Le plus gros modèle mesuré, Qwen2.5 14B, est le seul dont la confiance suit un peu la réussite, mais il reste sur-confiant de 36 points en moyenne, et un seul modèle par taille ne suffit pas à établir une règle. Ce n'est pas un classement.
Pourquoi tester une IA sur un labyrinthe ?
Parce que chaque décision y est vérifiable et que l'information y est cachée : le modèle ne voit ni les murs non découverts, ni le trésor, ni le dragon. À chaque déplacement, il donne la probabilité de ne pas heurter de mur, et le jeu dit aussitôt s'il avait raison. C'est une façon simple de mesurer la décision sous incertitude.
Peut-on refaire la mesure sur son propre PC ?
Oui. Le protocole et le moteur du labyrinthe sont publics sous licence MIT (dépôt outilsia-uncertainty-lab), les graines sont 0 à 9 et les fichiers bruts de cette campagne sont publiés. Le banc fera partie de la section « Qualité de décision » d'une prochaine version de Local Cockpit ; elle n'est pas dans la version 0.1.1 actuelle.
Sources : protocole outilsia-uncertainty-lab (MIT) · décomposition du score de Brier : A. H. Murphy, « A New Vector Partition of the Probability Score », Journal of Applied Meteorology, 1973 · intervalles de Wilson à 95 %. Mesures : OutilsIA, 9 octobre 2026, une seule machine. Dungeons & Dragons est une marque de Wizards of the Coast ; le jeu électronique de 1980 est de Mattel. OutilsIA n'est affilié à aucune de ces sociétés.